Dalam kelompok GPU, rangkaian bukan lapisan sokongan - ia menentukan sama ada pemecut mahal mengira atau duduk melahu menunggu data. Rangkaian kluster AI secara langsung membentuk kelajuan latihan, penggunaan GPU dan masa penyiapan kerja, dan ia berkelakuan sangat berbeza daripada rangkaian pusat data-tujuan umum. Panduan ini merangkumi cara mereka bentuk fabrik tanpa kerugian untuk beban kerja GPU: topologi, konfigurasi RoCEv2, optik dan kabel 400G/800G, dan pengesahan yang memisahkan fabrik yang lulus ujian lebar jalur daripada yang benar-benar menyelesaikan kerja latihan tepat pada masanya.
Reka Bentuk Rangkaian Kluster AI
Fabrik gugusan AI yang dibina dengan baik-memisahkan trafik bahagian hadapan dan bahagian belakang, menggunakan topologi tulang belakang-tidak menyekat atau rendah-terlebih langganan-untuk bahagian belakang, menjalankan RoCEv2 dengan PFC, ECN dan DCQCN ditala supaya ECN bertindak sebelum PFC, menyebarkan aliran besar pada pemuatan secara lalai{{5MPEC} secara bersendirian 400G hari ini dengan laluan yang jelas ke 800G, dan disahkan dengan telemetri yang berkorelasi dengan AI-seperti trafik kolektif - bukan sekadar ujian pemprosesan mudah.
Sekilas Pandang Reka Bentuk Rangkaian Kluster AI
| Keputusan | Lalai yang disyorkan |
|---|---|
| Domain trafik | Asingkan fabrik bahagian hadapan dan bahagian belakang |
| Topologi bahagian belakang | Daun-tulang belakang, tidak-menyekat atau terlebih langganan rendah |
| Pengangkutan | RoCEv2 dengan PFC + ECN + DCQCN |
| Pengimbangan beban | Kesesakan-sedar / dinamik, bukan ECMP lalai sahaja |
| Kelajuan pelabuhan | 400G sekarang, dengan migrasi 800G yang dirancang |
| Pengesahan | Trafik telemetri tambah kolektif (NCCL), bukan sahaja iperf |

Apakah Rangkaian Kluster AI?
Rangkaian kluster AI ialah fabrik berprestasi tinggi-yang menghubungkan pelayan GPU, storan, nod pengurusan dan kadangkala berbilang domain pusat data untuk latihan atau inferens. Satu kluster membawa beberapa jenis trafik - GPU-ke-komunikasi GPU, RDMA antara pelayan, storan membaca dan menulis, pengingesan set data, pemeriksaan, pengelogan dan orkestra - tetapi bahagian paling sensitif-berprestasi ialah fabrik latihan bahagian belakang yang membawa latihan GPU-kepada- Apabila fabrik itu perlahan atau tidak dapat diramalkan, GPU menunggu dan bukannya mengira.
Itulah sebabnya fabrik AI dinilai secara berbeza daripada rangkaian pusat data biasa. Jalur lebar mentah penting, tetapi begitu juga dengan konsistensi kependaman, tingkah laku kesesakan, kehilangan paket, kedalaman telemetri, topologi, dan juga penggunaan kuasa optik.
Mengapa Beban Kerja AI Menekankan Rangkaian Secara Berbeza
Latihan yang diedarkan sentiasa disegerakkan
Model besar melatih merentasi banyak GPU yang menukar kecerunan dan pengaktifan dalam fasa yang diselaraskan - corak kolektif seperti Semua-Kurangkan dan Semua-kepada-Semua. Akibatnya adalah tumpul: laluan paling perlahan boleh melambatkan keseluruhan langkah latihan. Walaupun 99% pautan adalah sihat, satu rak yang sesak-ke-pautan tulang belakang boleh menukar GPU menjadi pelik yang ditunggu-tunggu oleh orang lain.
Kependaman ekor membazirkan GPU, bukan kependaman purata
Kependaman purata ialah metrik yang salah di sini. Oleh kerana langkah penyegerakan menunggu GPU terakhir tiba, segelintir paket tertunda boleh menahan keseluruhan kerja. Pada kluster 256-GPU, satu pautan tulang belakang panas yang menambahkan kependaman ekor pada satu rel boleh menyeret penggunaan ke bawah merentas kerja.
Trafik AI diperbuat daripada aliran gajah
Rangkaian tradisional mengimbangi banyak aliran kecil; Kelompok AI menjana beberapa aliran-GPU yang besar dan lama-ke-GPU. Pencincangan ECMP lalai mengedarkan aliran, bukan bait, jadi apabila beberapa gajah mengalirkan cincang pada rak yang sama-ke-pautan tulang belakang, pautan itu menjadi panas manakala pautan selari melahu - menghasilkan pembentukan baris gilir, lonjakan kependaman dan akhirnya jatuh. Kelajuan port yang lebih tinggi tidak menyelesaikannya sendiri: pautan 400G masih sesak jika gajah mengalirkan hash dengan buruk ke atasnya.
Kehilangan paket sangat mahal
TCP biasa bertolak ansur dengan kerugian; RDMA berasaskan RoCEv2-tidak. Fabrik dijangka berkelakuan sebagai-rendah atau tidak rugi, dan jatuh semasa kesesakan boleh meruntuhkan prestasi RDMA. Inilah sebab keseluruhan fabrik RoCEv2 memerlukan kejuruteraan tanpa kerugian yang disengajakan dan bukannya pemajuan usaha terbaik.
Keperluan Teras untuk Rangkaian Kluster AI
Fabrik bahagian belakang yang baik perlu memenuhi beberapa keperluan sekaligus: jalur lebar pembahagian dua yang tinggi supaya banyak GPU boleh bercakap serentak tanpa fabrik menjadi halangan; rendahdan boleh diramalkependaman, kerana pancang kesesakan sekali-sekala adalah sama merosakkan kependaman purata tinggi; pengangkutan tanpa kehilangan atau hampir-tanpa kerugian untuk RoCEv2; topologi yang berskala tanpa cerucuk pada hop dan kabel; dan keterlihatan operasi yang mendalam. Pada titik terakhir - tanpa telemetri, pasukan secara rutin salah mendiagnosis masalah kesesakan rangkaian sebagai masalah GPU atau pengiraan dan menghabiskan hari mengejar lapisan yang salah.
Seni Bina Rangkaian Kluster AI: Fabrik Bahagian Depan lwn Belakang
Keputusan awal yang paling penting ialah sama ada untuk memisahkan rangkaian bahagian hadapan daripada fabrik latihan bahagian belakang. Bahagian hadapan membawa akses pengguna, pengurusan, orkestrasi, pemantauan, pengelogan, akses storan, pengingesan set data dan pemindahan pusat pemeriksaan - ia boleh kelihatan seperti rangkaian pusat data konvensional, walaupun storan dan pemeriksaan masih memerlukan daya pemprosesan sebenar. Bahagian belakang dikhususkan kepada GPU-kepada-trafik latihan GPU dan dioptimumkan untuk RDMA, kependaman rendah, pengangkutan tanpa kehilangan dan lebar jalur yang boleh diramal.
Pemisahan ini bukan teori. Kerja terbitan Meta padaRangkaian RoCE untuk latihan AI teragih pada skalamenerangkan dengan tepat pembahagian ini: rangkaian bahagian hadapan untuk tugas seperti pengingesan data, pemeriksaan dan pengelogan dan fabrik RoCEv2 bahagian belakang khusus yang menghubungkan NIC RDMA dalam seni bina bukan-sekat untuk komunikasi GPU. merekaKertas SIGCOMM 2024 mengenai RDMA melalui Ethernet pada skala Metamerangka idea yang sama seperti prinsip reka bentuk: fahami beban kerja dahulu, kemudian asingkan latihan GPU ke dalam rangkaian bahagian belakangnya sendiri supaya ia boleh berkembang dan berskala secara bebas.
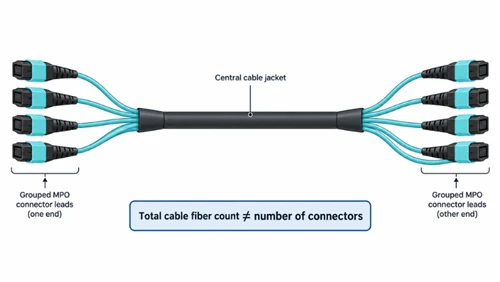
Sebab ia membuahkan hasil: mengasingkan domain meningkatkan kebolehramalan prestasi, kejelasan penyelesaian masalah, pengasingan dan{0}}penalaan kesesakan. Jika penyimpanan, pengurusan dan latihan semuanya berkongsi satu fabrik tanpa QoS yang teliti, penulisan pusat pemeriksaan yang berat boleh menghentikan komunikasi latihan pada saat yang paling teruk. Dalam reka bentuk Meta, suis daun menyambungkan GPU dalam rak di atas DAC kuprum, manakala rak-ke-pautan tulang belakang berjalan pada gentian mod-tunggal dengan transceiver 400G - corak yang dipetakan dengan bersih pada strukturKabel batang MPO/MTPantara peringkat daun dan tulang belakang.

RoCEv2 dan Lossless Ethernet: Cara Mereka Bekerja Bersama
RDMA (Akses Memori Terus Jauh) membenarkan satu sistem membaca atau menulis memori sistem lain dengan penglibatan CPU yang minimum, yang menyebabkan-kependaman rendah,-tinggi pemprosesan GPU-ke-pemindahan GPU mungkin. RoCEv2 membawa trafik RDMA melalui Ethernet dengan merangkumnya dalam UDP/IP, supaya anda boleh membina fabrik pada pensuisan Ethernet standard.
Daya tarikan adalah keluasan ekosistem. Ethernet mempunyai pangkalan pembekal yang besar, operasi matang dan evolusi pantas dalam silikon suis, optik dan perkakasan. TheKonsortium Ultra Ethernetmenjadikan ini hujah utamanya: timbunan Ethernet multivendor yang terbuka, boleh kendali, kini diformalkan dalam spesifikasi 1.0, tujuan-dibina untuk skala rangkaian AI dan HPC tanpa kunci vendor-masuk. NVIDIA telah menolak arah yang sama dari bahagian produk -nyaSpectrum-X platform Ethernetdiletakkan sebagai Ethernet yang direka khusus untuk AI, menambahkan pengangkutan tanpa kehilangan, penghalaan adaptif dan dalam-telemetri rangkaian kepada Ethernet standard.

Fabrik tanpa kehilangan RoCEv2, komponen demi komponen
"Lossless" bukanlah satu suis, ia adalah timbunan mekanisme kerjasama. Jadual di bawah ialah tahap perincian yang sebenarnya diperlukan oleh reka bentuk.
| Komponen | Peranan | Mengapa ia penting |
|---|---|---|
| Klasifikasi lalu lintas (DSCP/PCP) | Meletakkan RDMA ke dalam kelas tanpa kerugian | Penandaan yang salah menghantar RDMA ke dalam baris gilir yang hilang |
| PFC | Pautan-jeda peringkat untuk mengelakkan kejatuhan | Jaring keselamatan; penyalahgunaan menyebabkan ribut jeda dan{0}}sekatan-baris |
| ECN | Menandai paket sebelum antrian melimpah | Mesti mencetuskan sebelum PFC untuk berguna |
| DCQCN | Kawalan kadar NIC didorong oleh maklum balas ECN/CNP | Mengurangkan kekerapan PFC terpaksa menembak |
| Imbangan beban dinamik / adaptif | Hamparan gajah mengalir melintasi laluan | Pencincangan ECMP lalai meninggalkan pautan panas dan melahu |
| Telemetri | Mendedahkan titisan, tanda ECN, jeda PFC, kedalaman baris gilir | Satu-satunya cara untuk mengaitkan kesihatan fabrik dengan kesihatan pekerjaan |
Ini perlu ditala bersama. Hubungan kritikal ialah ambang ECN mesti beradadi bawahambang PFC masuk, jadi penghantar perlahan sebelum bingkai jeda diperlukan. Juniper'sdokumentasi DCQCNmenerangkan tindakan pengimbangan ini dengan tepat: biarkan ECN melakukan kawalan aliran dengan memotong kadar penghantaran lebih awal, jadi PFC - yang menghentikan aliran sepenuhnya - diminimumkan. Konfigurasikan ECN terlalu tinggi, dan PFC menyala dahulu dan selalunya; konfigurasikan PFC terlalu agresif, dan anda akan mendapat ribut jeda.
Maksud ini dalam amalan: Kaunter PFC bukanlah metrik kejayaan. Jika bingkai jeda PFC memanjat secara berterusan semasa latihan biasa dijalankan, fabrik itu tidak sihat - ia terselamat daripada kesesakan dengan menjeda lalu lintas. Fabrik yang benar-benar sihat menunjukkan ECN melakukan kerja dan PFC jarang menarik perhatian.
Cabaran Rangkaian Kluster AI Biasa dan Cara Menyelesaikannya
Cabaran 1: Kependaman ekor dan orang yang tersepit
Masalah:dalam latihan yang disegerakkan, satu laluan perlahan melambatkan keseluruhan kerja.lakukan:pastikan bahagian belakang rendah-hop; elakkan terlebih langganan yang tidak perlu; memantau kependaman ekor, bukan purata; gunakan kesesakan-pengimbangan beban sedar; sahkan dengan corak trafik kolektif dan bukannya ujian titik-ke-titik.Dalam amalan:kerja yang penggunaan GPUnya menyerlahkan setiap selang penyegerakan biasanya melanda laluan yang tersesat, bukan had pengiraan.
Cabaran 2: Kesesakan dan perlanggaran aliran-gajah
Masalah:beberapa aliran besar mendarat pada pautan yang sama dan mencipta hotspot.lakukan:jangan bergantung pada ECMP lalai untuk fabrik AI yang besar; dayakan pengimbangan beban dinamik/adaptif; tonton setiap-penggunaan tulang belakang dan kedalaman baris gilir; biarkan penghantar pendikit ECN dan DCQCN sebelum kesesakan berterusan.Dalam amalan:penggunaan pautan tidak rata-dengan semua yang lain nominal ialah tandatangan pencincangan aliran yang lemah, bukan lebar jalur yang tidak mencukupi.
Cabaran 3: Penskalaan daripada 400G kepada 800G
Masalah:apabila bilangan GPU bertambah,-pautan kelajuan yang lebih rendah memaksa lebih banyak suis, peringkat, optik dan kabel.lakukan:mengira lebar jalur yang diperlukan bagi setiap GPU dan setiap rak (pelayan 8-GPU dengan NIC 400G bagi setiap GPU ialah fabrik yang sangat berbeza daripada reka bentuk 200G); memutuskan untuk tidak-menyekat berbanding terlebih melanggan ringan dengan sengaja; pertimbangkan radix suis, kelajuan port, dan kedalaman topologi bersama-sama; rancang laluan 400G-ke-800G sebelum anda dipaksa masuk; simpan optik, kabel dan kuasa dalam reka bentuk dari hari pertama.
Cabaran 4: Pemilihan kuasa, penyejukan dan optik
Masalah:Fabrik AI menarik kuasa yang serius, terutamanya pada kelajuan port tinggi dan ketumpatan optik.lakukan:gunakan DAC untuk pendek dalam-pautan rak yang praktikal; gunakan AOC atau transceiver optik untuk rak yang lebih lama-ke-larian tulang belakang; bandingkan kuasa merentas pilihan optik; sahkan had terma pada-port berketumpatan tinggi; reka bentuk kabel dan aliran udara bersama-sama. Memilih antaratransceiver mod-satu dan berbilang modsebahagian besarnya adalah keputusan jangkauan-berbanding-kos, dan ia harus dibuat setiap kelas pautan, bukan sekali untuk keseluruhan kelompok.
Kuasa optik kini menjadi kekangan reka bentuk pesanan pertama-, bukan nota kaki. Kerja NVIDIA padakuasa-fabrik AI yang cekap dengan Spectrum-X Ethernet Photonicsmenggambarkan arah aliran secara langsung:-fotonik silikon berpakej bersama sedang digunakan untuk memotong kuasa setiap-port dan mengurangkan flap pautan berbanding dengan optik boleh pasang tradisional, tepat kerana transceiver adalah antara komponen kadar-kuasa dan{3}}kegagalan{3}}tertinggi dalam gugusan besar.
Cabaran 5: Keterlihatan dan menyelesaikan masalah titik buta
Masalah:tanpa telemetri, masalah rangkaian kelihatan seperti masalah pengiraan.lakukan:pantau kejatuhan paket, tanda ECN, bingkai jeda PFC, penghunian baris gilir, ralat pautan, penggunaan port, pengagihan aliran, kaunter kesesakan NIC, penggunaan GPU dan masa siap kerja - kemudian kaitkan metrik fabrik dengan metrik kerja AI. Suis yang kelihatan-senyap tidak menjamin kerja latihan yang sihat dan GPU yang sibuk tidak menjamin kemajuan yang berguna.
RoCEv2 lwn InfiniBand untuk Rangkaian Kluster AI
Kedua-dua RoCEv2/Ethernet dan InfiniBand menjalankan kluster AI dan HPC sebenar; pilihan bergantung pada skala, kemahiran pasukan, ekosistem, model kos dan matlamat operasi. Jadual di bawah ialah perbandingan editorial, bukan kedudukan mutlak - jawapan yang betul ialah beban kerja- dan organisasi-khusus.
| Faktor | RoCEv2 / Ethernet | InfiniBand |
|---|---|---|
| Ekosistem | Operasi yang luas, multivendor, biasa | Warisan HPC yang kukuh, timbunan-prestasi tinggi matang |
| operasi | Menggunakan semula kemahiran Ethernet, tetapi memerlukan penalaan tanpa kehilangan yang teliti | Lebih khusus, tujuan-dibina untuk HPC berganding rapat |
| Fleksibiliti sumber | Umumnya lebih banyak pilihan vendor | Selalunya timbunan yang lebih bersepadu |
| Prestasi | Kuat apabila direka dan ditala dengan betul | Terkenal dengan kependaman rendah dalam kelompok yang diganding rapat |
| Penskalaan | Memerlukan topologi yang disengajakan, kawalan kesesakan, telemetri | Pilihan yang kukuh untuk fabrik gaya HPC-besar |
| Paling sesuai | Pasukan yang mahukan fleksibiliti Ethernet dan reka bentuk RoCEv2 sedia AI- | Pasukan mengutamakan HPC bersepadu dan terbukti gandingan rapat |
Persoalan sebenar bukanlah teknologi mana yang menang secara abstrak. Ia adalah sama ada fabrik yang dipilih boleh menyampaikan lebar jalur yang boleh diramal, kependaman rendah, kehilangan rendah dan keterlihatan operasi pada skala GPU sasaran anda.
Skala GPU lwn Reka Bentuk Rangkaian
Kluster makmal 64-GPU dan kluster pengeluaran berbilang-ribu GPU bukanlah projek yang sama dengan kiraan port yang berbeza. Skala mengubah reka bentuk.
| Skala kluster | Reka bentuk tipikal | Fokus utama |
|---|---|---|
| Sehingga ~64 GPU (makmal / juruterbang) | Tulang belakang-satu atau dua{1}}daun-kecil, selalunya satu domain suis | Betulkan konfigurasi RoCEv2, kabel bersih, telemetri garis dasar |
| ~128–512 GPU | Tidak-menghalang dua-daun-tulang belakang, pemisahan bahagian hadapan/belakang | Sasaran terlebih langganan, pengimbangan beban dinamik, penalaan ECN/PFC |
| ~1,000–4,000+ GPU (pengeluaran) | Berbilang-peringkat atau rel-dioptimumkan, data-pusat-belakang berskala | Topologi-penjadualan sedar, 400G/800G, kuasa dan ketumpatan optik |
Langkah-demi-Langkah Rangka Kerja Rangkaian Kluster AI
Langkah 1: Tentukan beban kerja dan skala GPU
Mulakan dengan beban kerja, bukan model suis. Jelaskan kiraan GPU sekarang dan kitaran seterusnya, sama ada kerja itu adalah latihan,-penalaan halus, inferens atau bercampur, corak kolektif yang dijangkakan, saiz pusat pemeriksaan, volum trafik storan dan sama ada gugusan itu adalah penyewa- atau berbilang{3}}.
Langkah 2: Asingkan domain trafik
Tentukan apa yang dimiliki pada bahagian hadapan berbanding bahagian belakang: pengurusan, storan dan pusat pemeriksaan, latihan/RDMA dan memantau trafik. Untuk penempatan kecil, pemisahan logik dengan VLAN dan QoS mungkin mencukupi; untuk kelompok yang lebih besar, pemisahan fizikal antara bahagian hadapan dan hujung belakang biasanya lebih mudah untuk dikendalikan dan difikirkan.
Langkah 3: Pilih topologi dan sasaran terlebih langganan
Tulang belakang-daun ialah lalai untuk fabrik AI Ethernet berskala. Tentukan satu, dua atau lebih peringkat; tidak-menyekat berbanding terlebih melanggan; GPU setiap rak; NIC setiap pelayan; kelajuan dan kiraan pautan atas; kapasiti tulang belakang; dan saiz domain kegagalan. Untuk trafik latihan bahagian belakang, lebihan langganan membeli kebolehramalan - dan jika anda terlebih melanggan, jadikan nisbah yang disengajakan berdasarkan gelagat beban kerja yang diukur, bukan kemalangan kiraan port.
Langkah 4: Pilih kelajuan suis dan ketumpatan port
Pilih platform pensuisan pada lebar jalur, topologi dan pertumbuhan yang diperlukan - menilai 400G berbanding 800G, radix, jumlah kapasiti, seni bina penimbal, sokongan RoCEv2/PFC/ECN/DCQCN, telemetri, kuasa setiap port dan NOS/automasi. Jangan menilai kelajuan sahaja: suis pantas tanpa kawalan kesesakan, penimbalan dan telemetri yang betul masih akan menimbulkan masalah di bawah trafik AI.
Langkah 5: Rancang NIC, optik, DAC/AOC dan kabel
Kain lebih daripada suis. Rancang kelajuan NIC bagi setiap GPU, NIC-untuk-jenis pautan bertukar, DAC untuk pautan tembaga pendek, AOC dan modul optik untuk larian yang lebih lama, optik mod-tunggal untuk jarak dan loji gentian, susun atur tampalan, pelabelan dan akses perkhidmatan. Mendapatkan faktor bentuk boleh pasang dengan betul adalah penting di sini - aGambaran keseluruhan faktor bentuk-DD dan OSFP{1}}QSFPpatut dilihat sebelum melakukan suis dan port NIC pada 400G/800G. Pada bahagian pengkabelan, memecahkan port suis-ketumpatan tinggi kepada setiap-pautan pelayan biasanya bermaknaKabel pecah MPO-ke-LC, dan gred gentian hendaklah dipadankan dengan jarak - amalihad capaian gentian berbilang mod (OM1–OM5)tentukan di mana multimod masih berfungsi dan di mana mod tunggal-diperlukan. Reka bentuk pengkabelan yang lemah boleh menyebabkan topologi yang betul secara teknikal tidak dapat dikendalikan.
| Pautan kelas | Jarak biasa | Pilihan biasa |
|---|---|---|
| Dalam-rak GPU-ke-daun | Bawah ~3 m | DAC (tembaga) |
| Rak bersebelahan-. | ~3–7 m | AOC atau DAC |
| Daun-untuk-tulang belakang dalam dewan | Berpuluh meter hingga ~100 m | Multimod (OM4/OM5) + optik SR, atau mod-tunggal |
| Merentasi dewan / skala-DC | ~100 m hingga 2 km | Transceiver + 400G/800G mod tunggal |
Langkah 6: Konfigurasikan pengangkutan tanpa kehilangan dan kawalan kesesakan
Ini adalah bahagian yang paling sensitif dalam penggunaan. Kelaskan trafik RoCEv2 dengan betul dan petakannya ke keutamaan yang betul; dayakan PFC pada keutamaan itu; tetapkan ambang ECN di bawah ambang PFC; mengesahkan NIC melaksanakan respons DCQCN yang dimaksudkan; jauhkan trafik yang tidak berkaitan daripada kelas tanpa kerugian; dan uji secara eksplisit untuk menjeda ribut dan kepala-sekatan-garisan. Anggap PFC sebagai mekanisme keselamatan, bukan sebagai cara harian anda menjalankan rangkaian yang sesak.
Langkah 7: Sahkan dengan telemetri dan AI-seperti trafik ujian
Sebelum kerja pengeluaran dijalankan, sahkan lebar jalur-ke-akhir, pengedaran kependaman, kependaman ekor, penurunan paket, gelagat penandaan ECN, kekerapan jeda PFC,-pemulihan kegagalan pautan, pengedaran aliran dan prestasi kerja GPU di bawah beban. Daya pemprosesan iperf mudah tidak mencukupi - sahkan penandaan ECN, jeda PFC, kedalaman baris gilir dan NCCL semuanya-mengurangkan prestasibersama-sama, kerana fabrik yang melepasi ujian-ke-titik masih boleh tercekik pada komunikasi kolektif yang disegerakkan.
FAQ: Rangkaian Kluster AI
S: Bolehkah RoCEv2 benar-benar menggantikan InfiniBand untuk latihan AI?
J: Untuk banyak kelompok, ya - apabila fabrik Ethernet direka bentuk dan ditala dengan betul. Pengendali besar menjalankan latihan pengeluaran pada bahagian belakang RoCEv2, dan kedua-dua Konsortium Ultra Ethernet dan platform vendor seperti NVIDIA Spectrum-X mendorong Ethernet secara khusus ke arah prestasi skala AI-. Kaveatnya ialah RoCEv2 menuntut kejuruteraan tanpa kerugian yang disengajakan; ia tidak "hanya berfungsi" di luar kotak seperti mana-fabrik HPC yang digunakan untuk tujuan membina.
S: Bilakah saya sebenarnya memerlukan 800G dan bukannya 400G?
J: Apabila permintaan lebar jalur setiap-GPU dan setiap-rak melebihi apa yang boleh dibawa oleh pautan 400G tanpa menambah peringkat, kabel dan optik. Pelayan padat dengan-NIC berkelajuan tinggi bagi setiap GPU dan gugusan yang lebih besar di mana lebihan langganan akan merayap masuk, adalah pencetus biasa. Rancang laluan migrasi lebih awal supaya 800G adalah satu langkah, bukan reka bentuk semula.
S: Apakah yang berlaku jika PFC tersalah konfigurasi?
J: Konfigurasi PFC yang lemah boleh menyebabkan ribut jeda,-sekatan-garisan dan kesesakan merebak, dengan menjeda satu pautan menyandarkan trafik merentasi fabrik. Itulah sebabnya ECN harus membawa kebanyakan isyarat kesesakan dan PFC sepatutnya jarang terlibat; peningkatan kaunter PFC semasa larian biasa adalah tanda amaran, bukan penunjuk kejayaan.
S: Adakah rangkaian kluster AI perlu diasingkan secara fizikal?
J: Tidak selalu, tetapi kelompok yang lebih besar biasanya mendapat manfaat daripada mengasingkan fabrik latihan bahagian belakang secara fizikal daripada bahagian hadapan. Penggunaan yang lebih kecil selalunya boleh menggunakan pemisahan logik dengan VLAN dan QoS, dengan syarat storan dan semburan pusat pemeriksaan dijauhkan daripada kelas latihan tanpa kerugian.
S: Bagaimanakah cara saya memilih antara DAC, AOC dan transceiver optik?
J: Dengan jarak dan kuasa. DAC sesuai dengan-pautan kuprum rak pendek; AOC meliputi larian yang lebih panjang dan fleksibel; dan transceiver optik dengan multimod atau rak pemegang gentian mod-tunggal-ke-tulang belakang dan merentas-jarak dewan. Padankan gred gentian untuk dicapai, dan timbang kuasa optik, kerana transceiver adalah bahagian utama kuasa fabrik dan kadar kegagalan.
S: Adakah kluster GPU kecil memerlukan fabrik tanpa kerugian penuh?
J: Mereka masih memerlukan klasifikasi - konfigurasi RoCEv2 yang betul, PFC pada keutamaan yang betul dan ECN di bawah PFC - tetapi kelompok domain-tunggal yang kecil selalunya boleh melangkau topologi-berbilang peringkat dan perancangan terlebih langganan berat yang diperlukan oleh fabrik besar. Tingkah laku tanpa kerugian bukan pilihan; skala{6}}kerumitan ialah.
Kesimpulan dan Langkah Seterusnya
Rangkaian kluster AI memutuskan sama ada GPU berfungsi sebagai satu sistem yang diselaraskan atau menunggu data melahu. Reka bentuk yang kukuh menggabungkan lebar jalur tinggi, kependaman boleh diramal, pengangkutan RoCEv2 tanpa kehilangan, topologi tulang belakang-daun boleh skala, optik dan kabel yang betul serta telemetri yang cukup dalam untuk mengaitkan kesihatan fabrik dengan kesihatan pekerjaan. Kelompok kecil mendahului dengan topologi bersih dan konfigurasi RoCEv2 yang betul; kelompok besar juga mesti menangani pemisahan bahagian hadapan/belakang, kesesakan-pengimbangan beban sedar, penghijrahan 400G/800G, ketumpatan kuasa dan operasi-telemetri.
Langkah terbaik seterusnya ialah membetulkan input anda terlebih dahulu: skala GPU, corak beban kerja, reka bentuk rak dan domain trafik. Kemudian pilih suis, NIC, optik dan konfigurasi Ethernet tanpa kerugian untuk dipadankan. Jika anda membuat skop bahagian optik-kabel berstruktur daripada fabrik GPU secara selari,penyelesaian gentian dan kabel pusat databoleh membantu anda memadankan pilihan trunk, breakout dan transceiver dengan topologi dan jarak pautan anda. Dalam infrastruktur AI, rangkaian yang betul bukan sahaja lebih pantas - ia lebih boleh diramal, lebih boleh diperhatikan dan lebih mudah untuk skala.